
直白的回答
当真相比个性化更重要时,就无记忆地使用 AI。
当你需要连贯性时,记忆很有用;当你需要中立的回答时,记忆就有风险。如果 AI 了解你的偏好、担忧、项目、信念或过往对话,它可能会围绕你来塑造回答。
这对起草、规划和反复进行的个人工作流程可能很有帮助。但当你在核查事实、做决定、比较选项,或检验 AI 是否在对你撒谎时,更纯净的工作流程很简单:去除记忆,再问一次同样的问题,对比相互独立的模型,并在聊天之外进行核实。
AI 记忆何时会变成劣势。
当连贯性重要时,就使用记忆。当回答不应取决于你的档案、你的历史、你的担忧、你的风格,或 AI 与你建立的关系时,就避开记忆。下面每一种风险,同时也是使用 MultipleChat Compare Mode 的理由:同一个提示词、多个模型、并排呈现的回答,没有记忆档案左右结果。
1. 事实核查被个性化
记忆会让 AI 迎合你来回答,而不是中立地回答。因为它了解你的偏好,它可能会淡化事实、选择更稳妥的表述,或者回避冲突。
Compare Mode 去除了这种一对一的记忆关系,并排展示多个相互独立的回答。
2. 高风险建议变得过于个人化
法律、医疗、金融、招聘、移民、安全和商业方面的回答应当基于证据,而不是基于 AI 记住的关于你处境或情绪的背景信息。
使用 MultipleChat 一次向最多 4 个模型提问,然后在采取行动前,核实它们存在分歧的说法。
3. 谄媚倾向加剧
如果 AI 记住了你的信念、目标和过往的论点,它可能更倾向于附和、奉承或认可你,而不是纠正你。
并排对比能让过度附和一目了然,因为另一个模型可能会质疑同一个前提。
4. 不同的人得到不同的“真相”
同一个提示词可能产生不同的回答,因为每个人的记忆历史都不同。这对便利性有用,对真相却很危险。
MultipleChat 为你提供更纯净的基准:一个提示词、多个模型、差异清晰可见。
5. 确认偏误被自动化
一个有记忆的 AI 可能会不断强化它从你身上学到的世界观,尤其是当你经常奖励那些符合你观点的回答时。
Compare Mode 把一个随声附和的回答,变成一组可以相互检验的回答。
6. 情感依赖加深
记忆让 AI 显得更连贯、更亲密、更忠诚。这可能会模糊“有用的助手”与“被关系塑造的权威”之间的界线。
MultipleChat 让工作流程始终聚焦于任务:对比输出、审视分歧、依据证据做决定。
7. 隐私暴露随时间增加
记忆中可能包含个人事实、工作细节、健康线索、家庭背景、信念、习惯和敏感项目。
Compare Mode 不会把你的偏好保存到记忆档案中,因此对比结果更纯净。
8. 跨领域串扰污染回答
来自生活某一方面的记忆可能影响另一方面:个人焦虑渗入商业建议,或者工作背景渗入私人决定。
当你希望回答与你平常的个人背景分开时,就在 Compare Mode 中提问。
9. 旧记忆持续左右新回答
AI 可能记得你以前的工作、旧目标、旧偏好、旧关系或旧限制,并持续围绕它们进行优化。
一次全新的对比,有助于发现某个模型何时被过时的背景信息锚定,而不是针对当前的问题作答。
10. 隐藏的假设变得不可见
回答可能同时受到已保存的记忆、聊天记录、项目背景、自定义指令、文件、应用数据和当前提示词的影响。
MultipleChat 让对比一目了然,你可以看到哪些说法在脱离单一系统的上下文堆栈后依然成立。
11. 排查错误回答变得更难
当回答出错时,你很难判断问题出在提示词、模型、记忆,还是旧的对话上下文。
同时向多个模型提问。如果只有一个回答很奇怪,你就知道该先从哪里查起。
12. 结果更难复现
一次干净的测试应当可以重复。记忆会让同一个提示词对不同用户、甚至对同一用户在之后的使用中,意味着不同的东西。
Compare Mode 为你提供可重复的起点:同一个提示词、同一个视图、多个模型的输出。
13. 研究和基准测试受到污染
如果你在测试 AI 的质量,记忆就是噪声。它会改变输入,让模型对比变得不公平。
MultipleChat 专为对比而打造:只需提问一次,并排查看各个输出,找出不稳定的说法。
14. 个性化可能变成说服
如果一个系统知道什么能激励你、让你担忧、让你安心或说服你,它就能让回答显得更有说服力,却不会让它更真实。
使用 MultipleChat,把有说服力的语气与各模型在事实上的一致性区分开来。
15. 机密背景可能扩散得太远
如果记忆或项目背景被重复使用,客户、雇主、患者、学生或项目的背景信息可能会意外地影响无关的工作。
对于敏感的核查,请在不依赖已记住的个人档案的工作流程中进行对比。
16. 团队记忆模糊了责任归属
在团队或项目系统中,记忆有助于保持连贯性,但也可能掩盖究竟是哪些背景影响了回答、实际上又是谁提供了这些背景。
MultipleChat 为团队提供一个可见的对比界面,而不是把判断埋藏在某个助手的记忆里。
17. 熟悉感带来虚假的自信
一个了解你的 AI 听起来可能更自信、更有帮助,但那是因为它掌握了背景信息,而不是因为它有更有力的证据。
并排的回答能帮你区分“自信”与“跨模型的一致”。
18. 偏好锁定限制了更好的想法
如果 AI 一直围绕你过去的风格、工具、工作流程和品味进行优化,它可能就不再向你展示那些陌生但更好的选择。
Compare Mode 让不同的模型呈现不同的角度,而不是由一个助手重复你一贯的路径。
19. 安全措辞可能过于个人化
记忆可能会影响系统变得多谨慎、多回避、多直接或多保护性,尤其是在敏感话题上。
当某个回答感觉被过度过滤或过度软化时,先与其他模型对比,再决定是否相信它。
20. 关联应用扩大了上下文范围
视产品和设置而定,个性化可能会调用你的邮件、文件、日程、联系人、搜索记录、视频、位置和设备信息。
当你想对比模型,又不希望更广泛的应用生态在背后悄悄左右回答时,就使用 MultipleChat。
更纯净的工作流程。
从一个干净的提示词开始
告诉 AI 不要使用之前的上下文:“请在完全不记得我的前提下回答。不要推断我的偏好或目标。”
对比不止一个模型
把同一个问题发给多个模型。如果某个回答格外让人安心、闪烁其词或过于自信,对比会让这一点暴露无遗。
核查发生变化的说法
最重要的部分,是那些在不同模型、不同账户或不同记忆设置下有所差异的说法。先核实这些。
使用 MultipleChat Compare Mode
一种实用方法:使用 AI,却不受被记忆塑造的“关系”影响。
MultipleChat Compare Mode 会把同一个提示词同时发送给最多 4 个 AI 模型,并排呈现。模型不知道你是谁,Compare Mode 也不会把你的偏好保存到会影响未来回答的记忆档案中。
启用 Compare Mode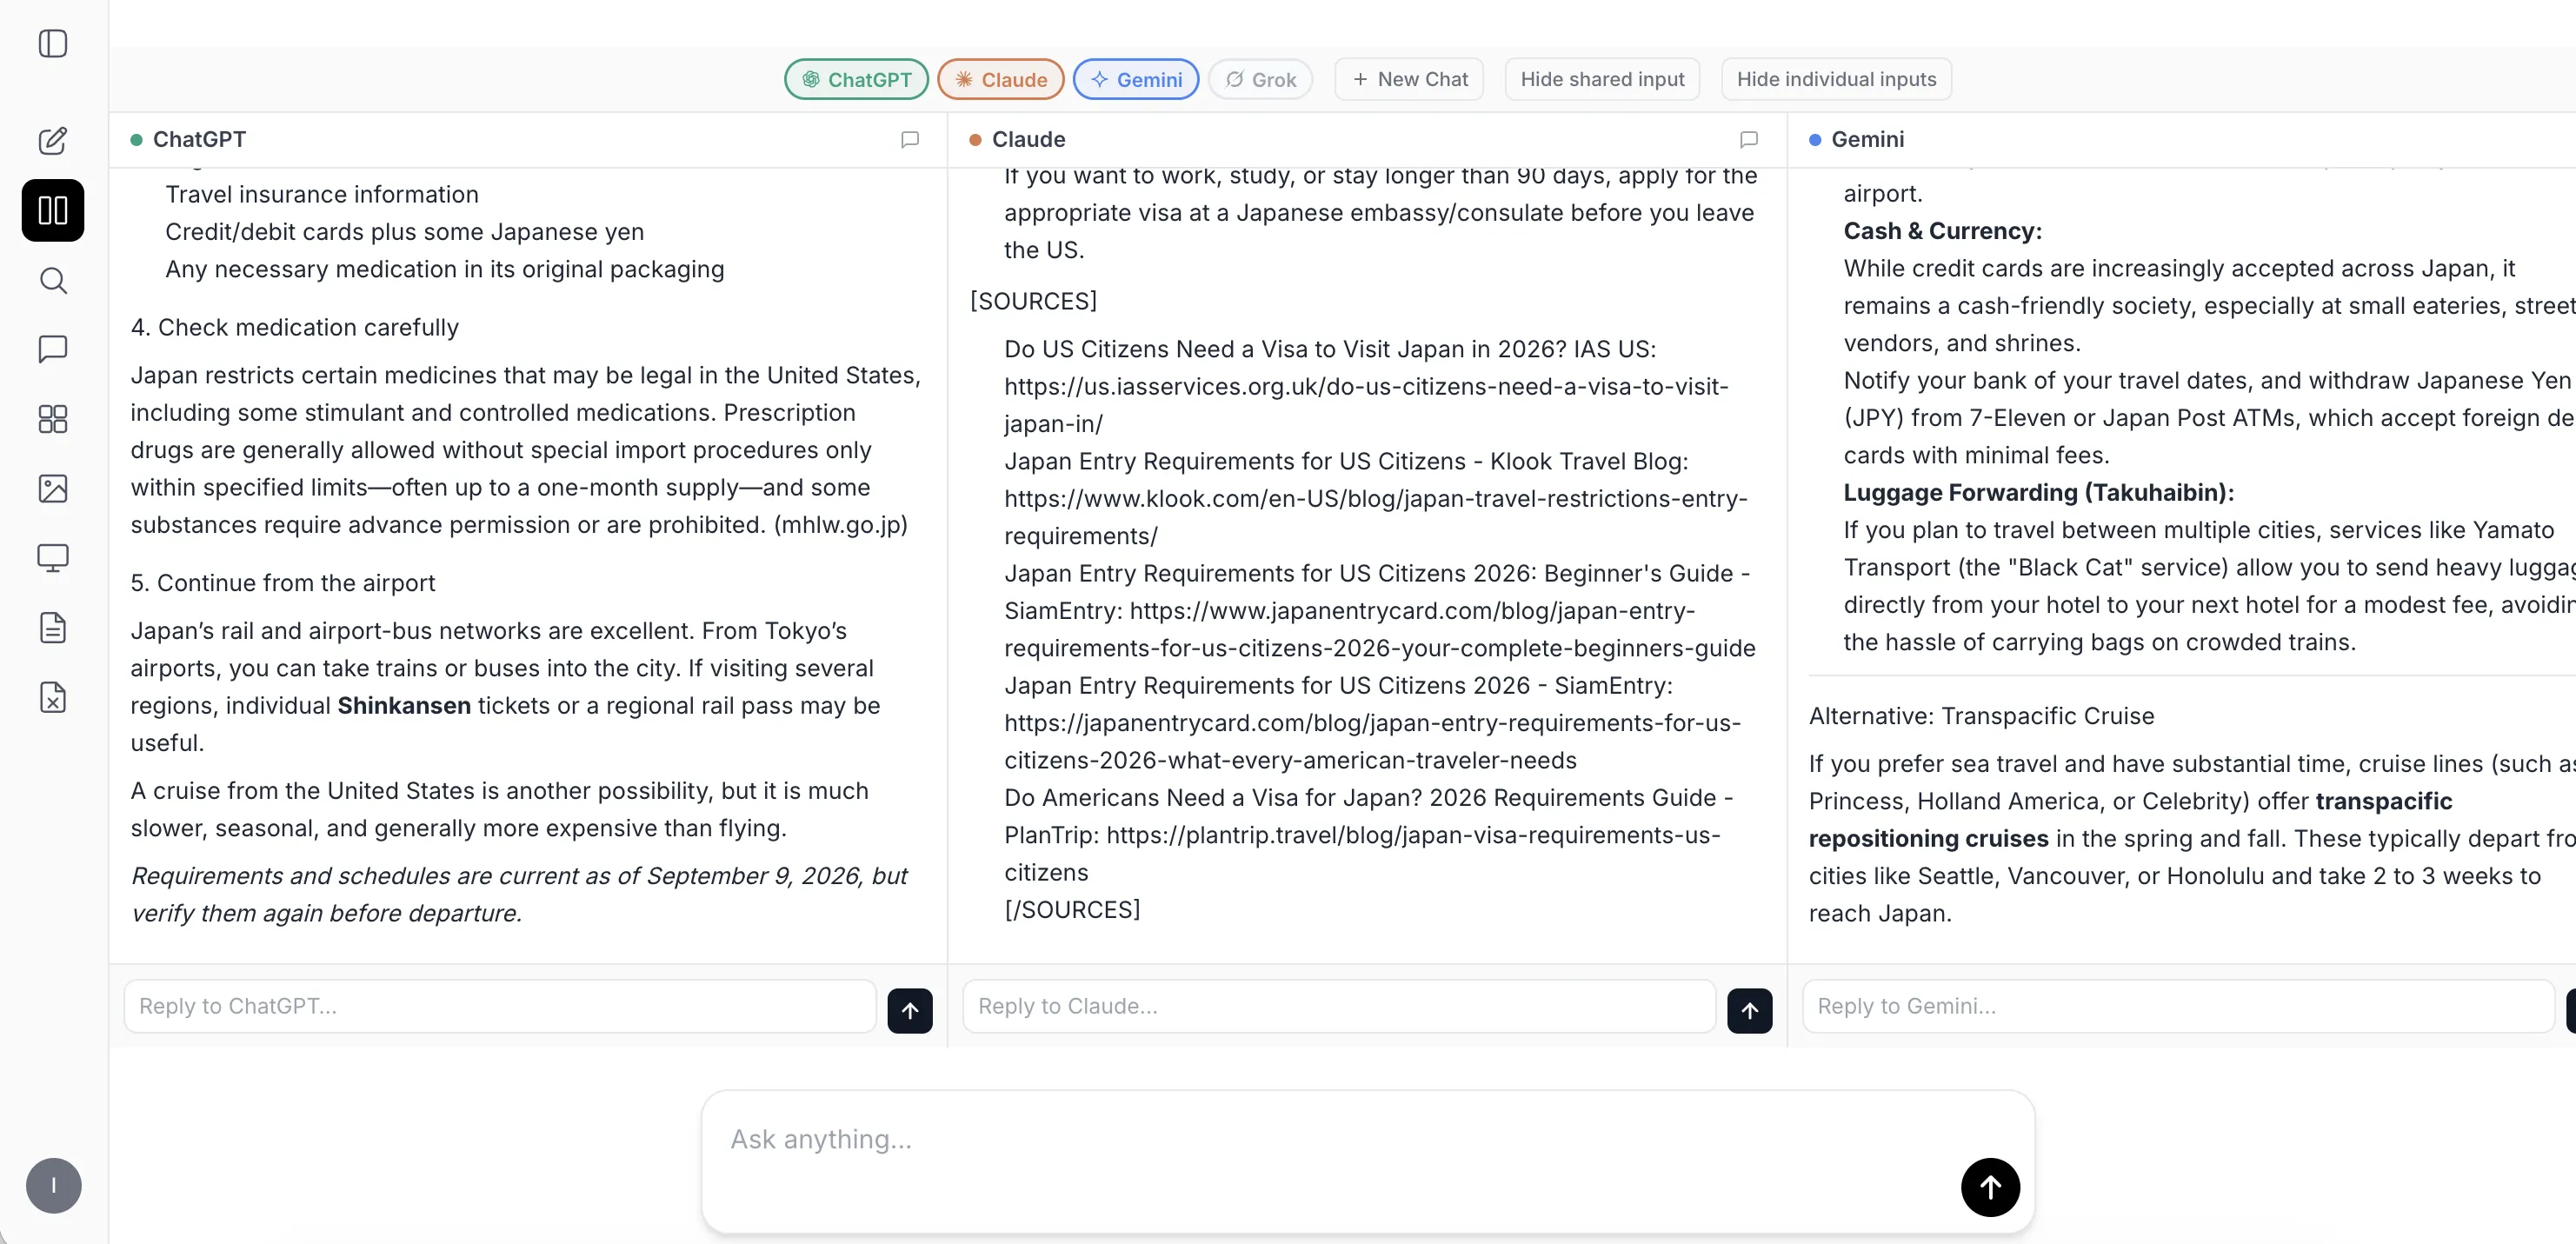
这正是核心优势:你不再被困在某一个模型的记忆、某一个模型的语气,或某一个模型版本的答案里。
复制这个提示词。
无记忆测试提示词
“请在完全不记得我的前提下回答这个问题。不要使用之前的对话、已保存的偏好或对我目标的任何假设。先给出中立的回答,然后列出如果启用个性化,答案可能会有哪些变化。”
对于高风险的问题,在这个提示词之后再追问:“你的回答中,哪一条说法最需要外部核实?”然后在对话之外核实这条说法。
总结
记忆有用,但中立是另一回事。
当你需要连贯性时,就使用记忆。当回答需要更少个人化、更易于对比、更易于核实时,就无记忆地使用 AI。
常见问题
试试更纯净的工作流程
只问一次。对比多个回答。消除记忆偏差。
使用 MultipleChat Compare Mode,并排获取来自多个 AI 模型的最多 4 个回答。Compare Mode 不会在记忆中保存你的偏好,AI 模型也不知道你是谁。
启用 Compare Mode