
짧은 답변
네, AI는 거짓말을 할 수 있습니다.
일부러 그러는 것은 아닙니다. AI 모델에는 동기가 없습니다. 하지만 사실, 인용문, 판례를 지어내 자신 있는 어조로 제시하면서 잘못되었다는 단서를 전혀 남기지 않을 수 있습니다. 그 답변에 의존하는 사람에게는 그것이 곧 거짓말입니다.
주된 원인은 환각입니다. 일부는 선택적인 프레이밍, 안전을 의식한 답변, 개인화에서 비롯됩니다. 메모리가 있는 어시스턴트는 사용자에 대해 아는 정보에 맞춰 답변을 구성할 수 있습니다. 어떤 경우든 해결책은 같습니다. 한 모델의 답변 하나를 최종 결론으로 삼지 마세요.
설명
유창하고 자신 있지만 사실이 아닌 답변. 전체 정의는 AI 용어집에서 확인하세요.
발생하는 이유
모델은 그럴듯한 단어를 예측하며, 추측이 보상받는 경향이 있습니다.
잡아내는 방법
여러 모델을 교차 확인하고 모든 출처를 열어 보세요.
실제 결과로 이어진 AI 환각 사례
가정이 아니라 실제로 기록된 사례입니다. 모든 사례에서 AI의 답변은 전문적으로 보였지만 결국 틀린 것으로 드러났습니다.
Mata v. Avianca: 지어낸 판례
뉴욕의 한 인신 상해 소송에서 변호사들이 ChatGPT가 지어낸 판례를 인용한 서면을 제출했습니다. 연방 판사는 이들에게 제재를 가하고 $5,000의 벌금을 부과했습니다.
교훈: 그럴듯해 보이는 인용이라고 해서 실제로 존재한다는 증거는 아닙니다.
Google Bard의 망원경 오류
홍보용 시연에서 Bard는 제임스 웹 우주망원경이 태양계 밖 행성을 처음으로 촬영했다고 답했습니다. 그 이미지는 실제로 2004년에 다른 망원경이 촬영한 것이었습니다. 그날 Alphabet 주가는 7.7% 하락했습니다.
교훈: 제조사가 직접 내세운 시연 답변조차 틀릴 수 있습니다.
Air Canada 챗봇의 정책 안내
항공사 웹사이트의 챗봇은 유족이 된 고객에게 여행 후에도 유족 할인을 신청할 수 있다고 안내했습니다. 실제 정책은 그렇지 않았습니다. 재판소는 챗봇이 스스로 책임을 진다는 Air Canada의 주장을 기각하고 배상을 명령했습니다.
교훈: AI 답변은 공식 정책 페이지와 대조해 확인하세요.
AI는 왜 환각을 일으키나요?
간단히 말해 언어 모델은 다음에 올 텍스트를 매우 잘 예측하는 도구일 뿐, 데이터베이스가 아닙니다. 모르는 것이 있으면 멈추는 대신 가장 그럴듯하게 들리는 답변을 만들어 내는 경우가 많습니다.
찾아보는 것이 아니라 예측합니다. 모델이 검색이나 사용자의 파일에 연결되어 있지 않으면 학습 중에 익힌 패턴으로 답하며, 그 패턴은 틀릴 수 있습니다.
드문 사실에는 패턴이 없습니다. 문법과 상식은 수백만 개의 문서에서 반복됩니다. 하지만 특정인의 생일이나 잘 알려지지 않은 판결은 그렇지 않을 수 있어, 모델이 빈틈을 채워 버립니다.
추측이 보상받습니다. OpenAI 연구진은 2025년, 일반적인 학습 방식과 벤치마크 채점이 운 좋은 추측에는 점수를 주고 “모르겠습니다”에는 아무 점수도 주지 않아 모델이 자신 있는 답변 쪽으로 기운다고 주장했습니다(OpenAI).
학습 데이터는 낡습니다. 가격, 법률, 제품명, 인물 정보는 모델의 학습 기준일 이후에도 계속 바뀝니다.
프롬프트가 부추길 수 있습니다. 유도 질문(“어떤 연구가 …을 증명하나요?”)이나 모델이 갖고 있지 않은 출처를 요청하면 출처를 지어내도록 유도하게 됩니다.
AI가 오해를 일으키는 방식은 환각만이 아닙니다
틀린 답변의 대부분은 환각입니다. 그 외 몇 가지 메커니즘은 기술적으로는 변명의 여지가 있지만 결국 잘못된 인식을 남기는 답변을 만듭니다.
메모리 테스트용 프롬프트
“나에 대한 기억이 전혀 없다고 가정하고 이 질문에 답해 주세요. 그다음 나에 대해 아는 내용을 활용해 다시 답해 주세요. 무엇이 달라졌는지 정확히 보여 주세요.”
AI 환각을 잡아내는 방법
“확실한가요?”라고 묻는 것만으로는 부족합니다. 모델은 두 번 연속 자신 있게 틀릴 수 있습니다. 대화 밖에서 답변을 검증하세요.
서로 독립된 모델로 교차 확인
같은 질문을 여러 모델에 보내세요. 의견이 일치한다고 증거가 되는 것은 아니지만, 의견이 갈리면 어떤 주장을 확인해야 하는지 정확히 알 수 있습니다. MultipleChat은 Auto Verification으로 이를 자동으로 수행합니다.
모든 출처 열어 보기
링크를 클릭하고, 인용문을 찾고, 판례를 읽어 보세요. 출처를 찾을 수 없다면 그 주장은 검증되지 않은 것으로 간주하세요.
깨끗한 맥락에서 다시 질문하기
메모리를 끈 새 채팅을 사용하세요. 답변이 크게 달라진다면 개인화가 답변에 영향을 주고 있었던 것입니다. 메모리 없이 AI를 사용하는 방법을 참고하세요.
중요한 질문은 전문가에게
법률, 의료, 금전, 안전, 고용 관련 문제라면 AI는 출발점으로만 활용하고, 공신력 있는 출처나 자격을 갖춘 전문가를 통해 확인하세요.
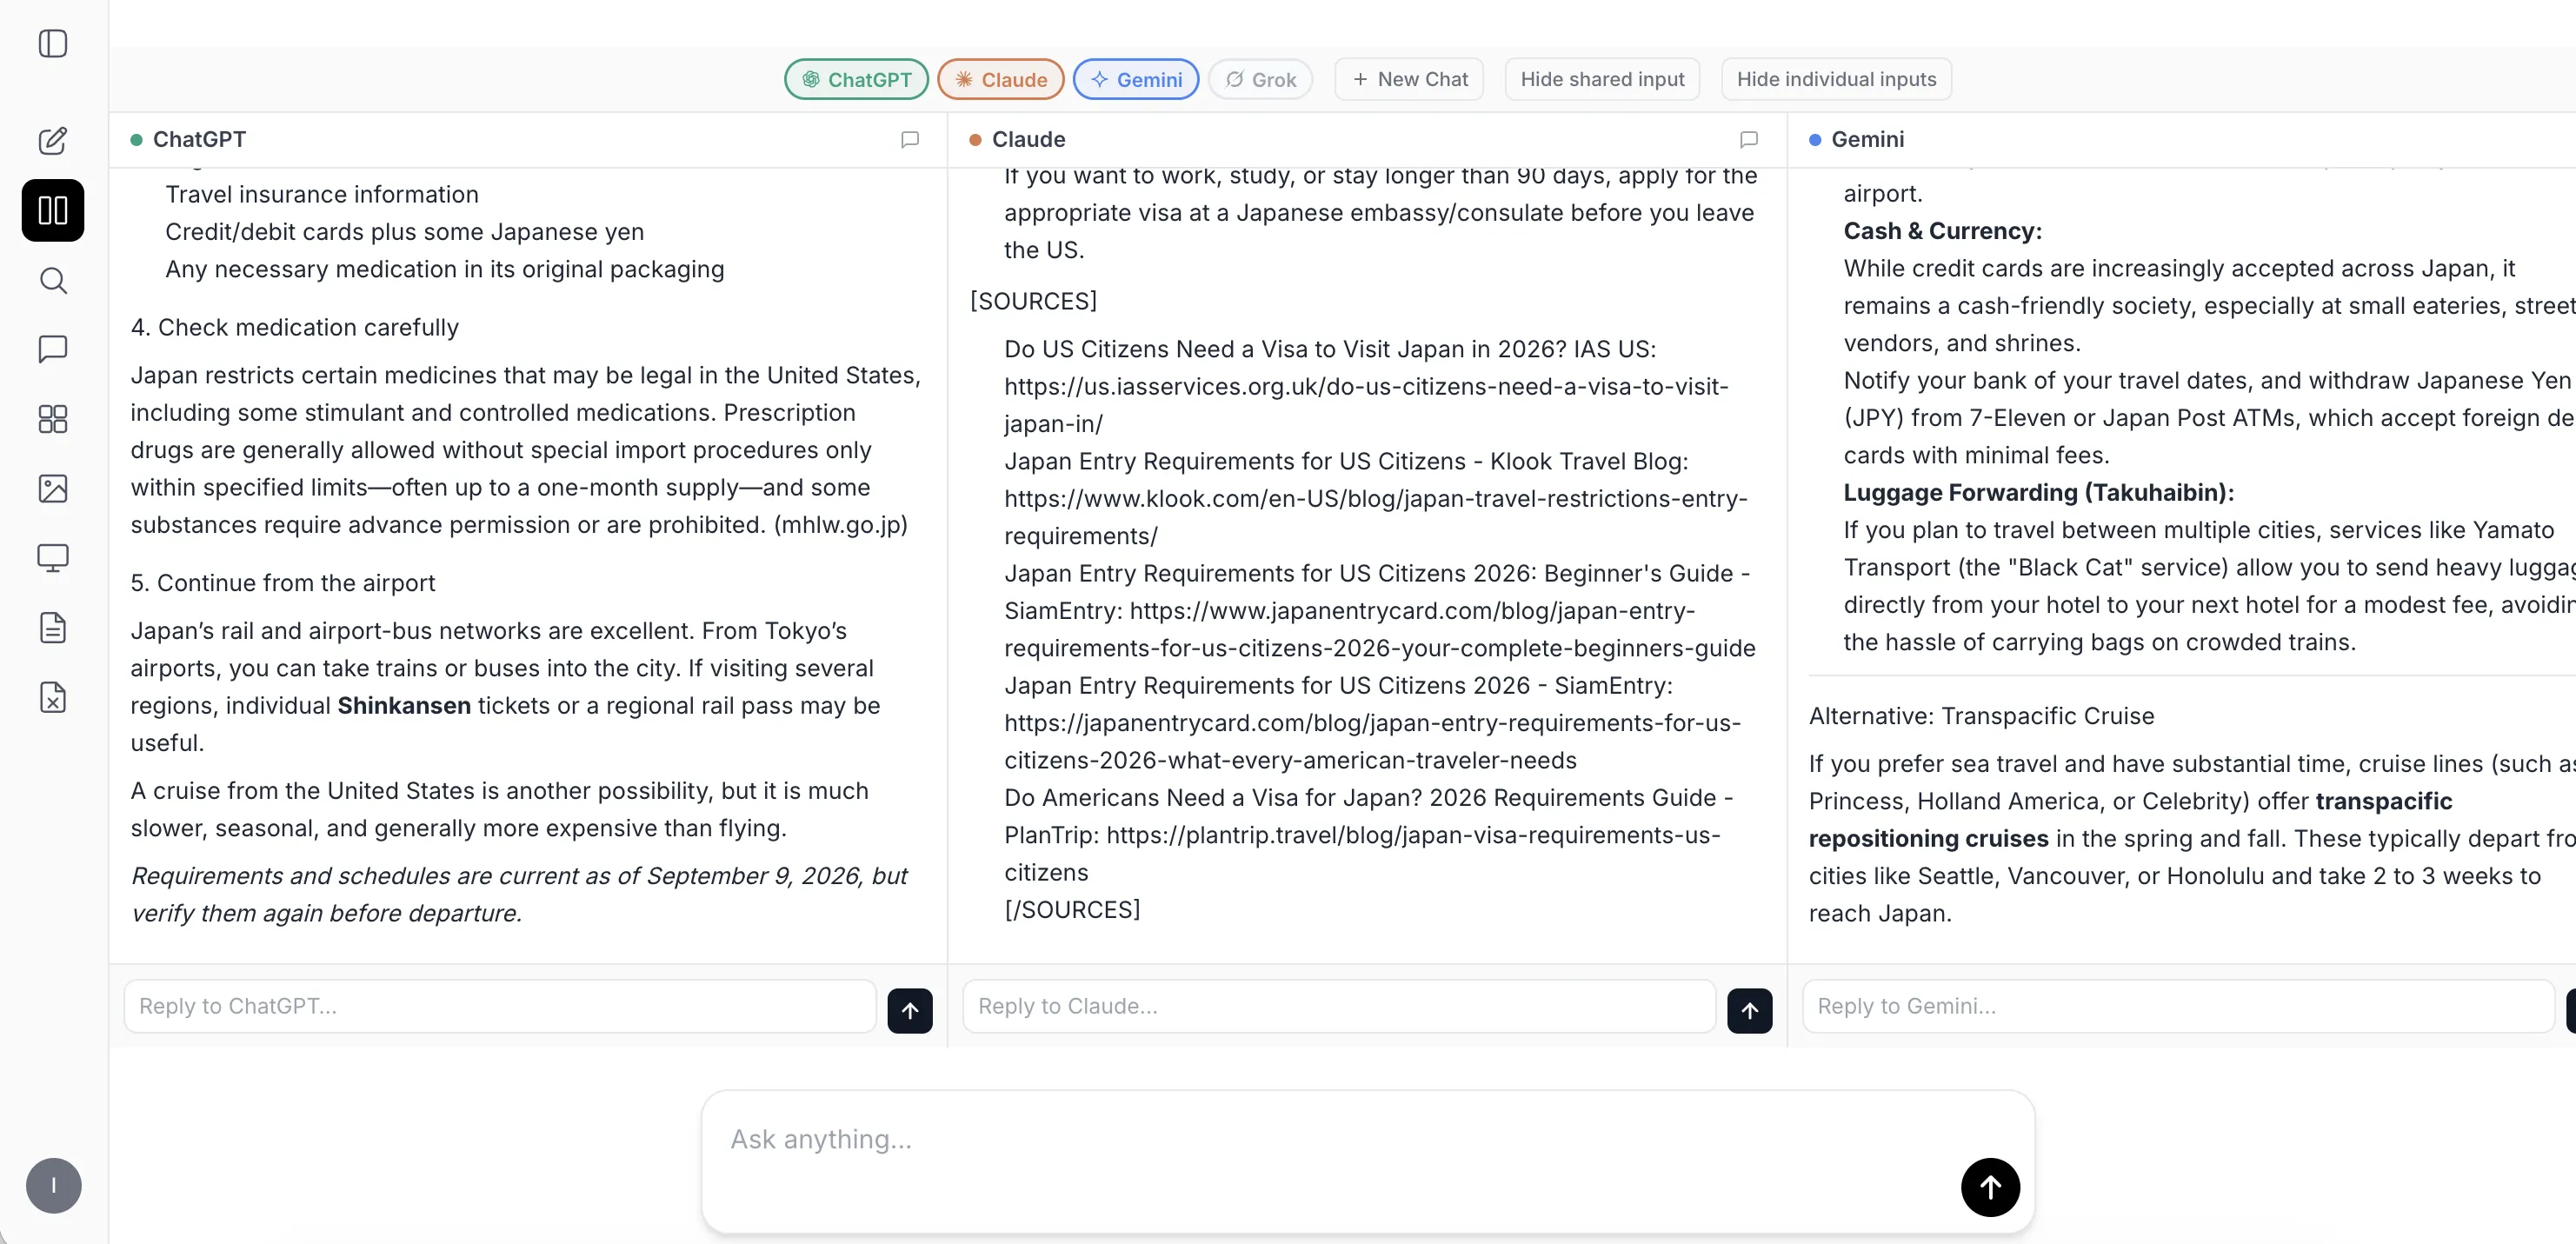
MultipleChat Compare Mode 사용하기
메모리에 좌우되는 관계 없이 최대 4개의 AI 답변을 나란히 받아 보세요.
Compare Mode는 같은 질문을 여러 AI 모델에 동시에 보내고 답변을 나란히 보여 줍니다. 이후 답변에 영향을 주는 메모리 프로필에 사용자의 선호를 저장하지 않습니다.
결론
AI는 거짓말을 할 수 있습니다. 답변 하나는 사실이 아니라 초안으로 여기세요.
AI 환각은 드문 오류가 아니라 오늘날 모델이 지닌 잘 알려진 특성입니다. 중요한 답변이라면 행동하기 전에 모델을 비교하고, 출처를 열어 보고, 메모리 없이 질문하세요.
자주 묻는 질문
더 안전한 워크플로를 사용해 보세요
AI 하나가 현실을 정의하게 두지 마세요.
MultipleChat Compare Mode로 서로 다른 AI 모델의 답변을 최대 4개까지 나란히 받아 보고, 의견이 갈리는 지점에서 환각을 찾아내세요.
Compare Mode 활성화