
Die kurze Antwort
Ja, KI kann Sie anlügen.
Nicht absichtlich. Ein KI-Modell hat kein Motiv. Aber es kann eine Tatsache, ein Zitat oder einen Gerichtsfall erfinden, ihn in selbstbewusstem Ton präsentieren und Ihnen keinerlei Hinweis darauf geben, dass etwas nicht stimmt. Für die Person, die sich auf die Antwort verlässt, ist das eine Lüge.
Halluzination ist die Hauptursache. Ein kleinerer Teil geht auf selektive Darstellung, durch Sicherheitsvorgaben geprägte Antworten und Personalisierung zurück: Ein Assistent mit Gedächtnis kann seine Antwort an dem ausrichten, was er über Sie weiß. Die Lösung ist in jedem Fall dieselbe: Lassen Sie nicht eine einzige Antwort eines einzigen Modells das letzte Wort haben.
Was es ist
Eine flüssige, selbstbewusste Antwort, die falsch ist. Die vollständige Definition finden Sie im KI-Glossar.
Warum es passiert
Modelle sagen wahrscheinliche Wörter voraus, und Raten wird tendenziell belohnt.
Wie Sie es erkennen
Modelle gegenprüfen und jede Quelle öffnen.
Echte KI-Halluzinationen mit echten Folgen
Das sind dokumentierte Fälle, keine Gedankenspiele. In jedem davon wirkte die Antwort der KI professionell und erwies sich als falsch.
Mata v. Avianca: erfundene Gerichtsfälle
Anwälte in einem New Yorker Personenschadensfall reichten einen Schriftsatz mit Fällen ein, die ChatGPT erfunden hatte. Ein Bundesrichter verhängte Sanktionen und eine Geldstrafe von 5.000 $.
Lehre: Eine Quellenangabe, die richtig aussieht, beweist nicht, dass die Quelle existiert.
Der Teleskop-Fehler von Google Bard
In einer Werbedemo behauptete Bard, das James-Webb-Weltraumteleskop habe das erste Bild eines Planeten außerhalb unseres Sonnensystems aufgenommen. Dieses Bild war jedoch bereits 2004 von einem anderen Teleskop aufgenommen worden. Die Alphabet-Aktie fiel an diesem Tag um 7,7 %.
Lehre: Selbst die Vorzeige-Antwort eines Anbieters kann falsch sein.
Die Chatbot-Richtlinie von Air Canada
Der Chatbot auf der Website der Airline sagte einem trauernden Kunden, er könne einen Trauerfall-Rabatt nach der Reise geltend machen. Die tatsächliche Richtlinie sah etwas anderes vor. Ein Tribunal wies das Argument von Air Canada zurück, der Chatbot sei für sich selbst verantwortlich, und verurteilte die Airline zur Zahlung.
Lehre: Prüfen Sie KI-Antworten anhand der offiziellen Richtlinienseite.
Warum halluziniert KI?
Kurz gesagt: Ein Sprachmodell sagt sehr gut voraus, welcher Text als Nächstes kommen sollte. Es ist keine Datenbank. Wenn es etwas nicht weiß, liefert es oft die plausibelste Antwort, statt aufzuhören.
Es sagt voraus, statt nachzuschlagen. Sofern das Modell nicht mit einer Suche oder Ihren Dateien verbunden ist, antwortet es aus Mustern, die es im Training gelernt hat – und Muster können falsch sein.
Seltene Fakten haben kein Muster. Grammatik und Allgemeinwissen wiederholen sich in Millionen von Dokumenten. Der Geburtstag einer bestimmten Person oder ein Nischenurteil vielleicht nicht – also füllt das Modell die Lücke.
Raten wird belohnt. Forschende von OpenAI argumentierten 2025, dass gängiges Training und Benchmark-Bewertungen Glückstreffer honorieren und für „Ich weiß es nicht“ nichts vergeben, was Modelle zu selbstbewussten Antworten drängt (OpenAI).
Trainingsdaten veralten. Preise, Gesetze, Produktnamen und Personen ändern sich nach dem Trainingsstichtag eines Modells.
Ihr Prompt kann es verleiten. Eine Suggestivfrage („Welche Studie beweist …?“) oder die Bitte um Quellen, die das Modell nicht hat, lädt es dazu ein, welche zu erfinden.
Halluzination ist nicht der einzige Weg, auf dem KI in die Irre führt
Die meisten falschen Antworten sind Halluzinationen. Einige andere Mechanismen erzeugen Antworten, die technisch vertretbar sind, Ihnen aber trotzdem ein falsches Bild vermitteln.
Test-Prompt für das Gedächtnis
„Beantworte das so, als hättest du keinerlei Erinnerung an mich. Antworte dann noch einmal mit dem, was du über mich weißt. Zeige genau, was sich geändert hat.“
So erkennen Sie eine KI-Halluzination
„Bist du sicher?“ reicht nicht. Ein Modell kann sich zweimal mit Überzeugung irren. Prüfen Sie die Antwort von außerhalb des Gesprächs.
Unabhängige Modelle gegenprüfen
Senden Sie dieselbe Frage an mehrere Modelle. Übereinstimmung ist kein Beweis, aber Widerspruch zeigt genau, welche Aussage Sie prüfen sollten. MultipleChat erledigt das mit Auto Verification automatisch.
Jede Quelle öffnen
Klicken Sie auf den Link, suchen Sie das Zitat, lesen Sie den Fall. Lässt sich eine Quelle nicht finden, behandeln Sie die Aussage als unbestätigt.
In einem neutralen Kontext erneut fragen
Nutzen Sie einen neuen Chat mit deaktiviertem Gedächtnis. Ändert sich die Antwort wesentlich, hat die Personalisierung sie geprägt. Siehe KI ohne Gedächtnis nutzen.
Folgenreiche Fragen weitergeben
Bei Recht, Medizin, Geld, Sicherheit oder Beschäftigung nutzen Sie KI als Ausgangspunkt und lassen die Antwort durch eine maßgebliche Quelle oder eine qualifizierte Fachperson bestätigen.
Compare Mode von MultipleChat nutzen
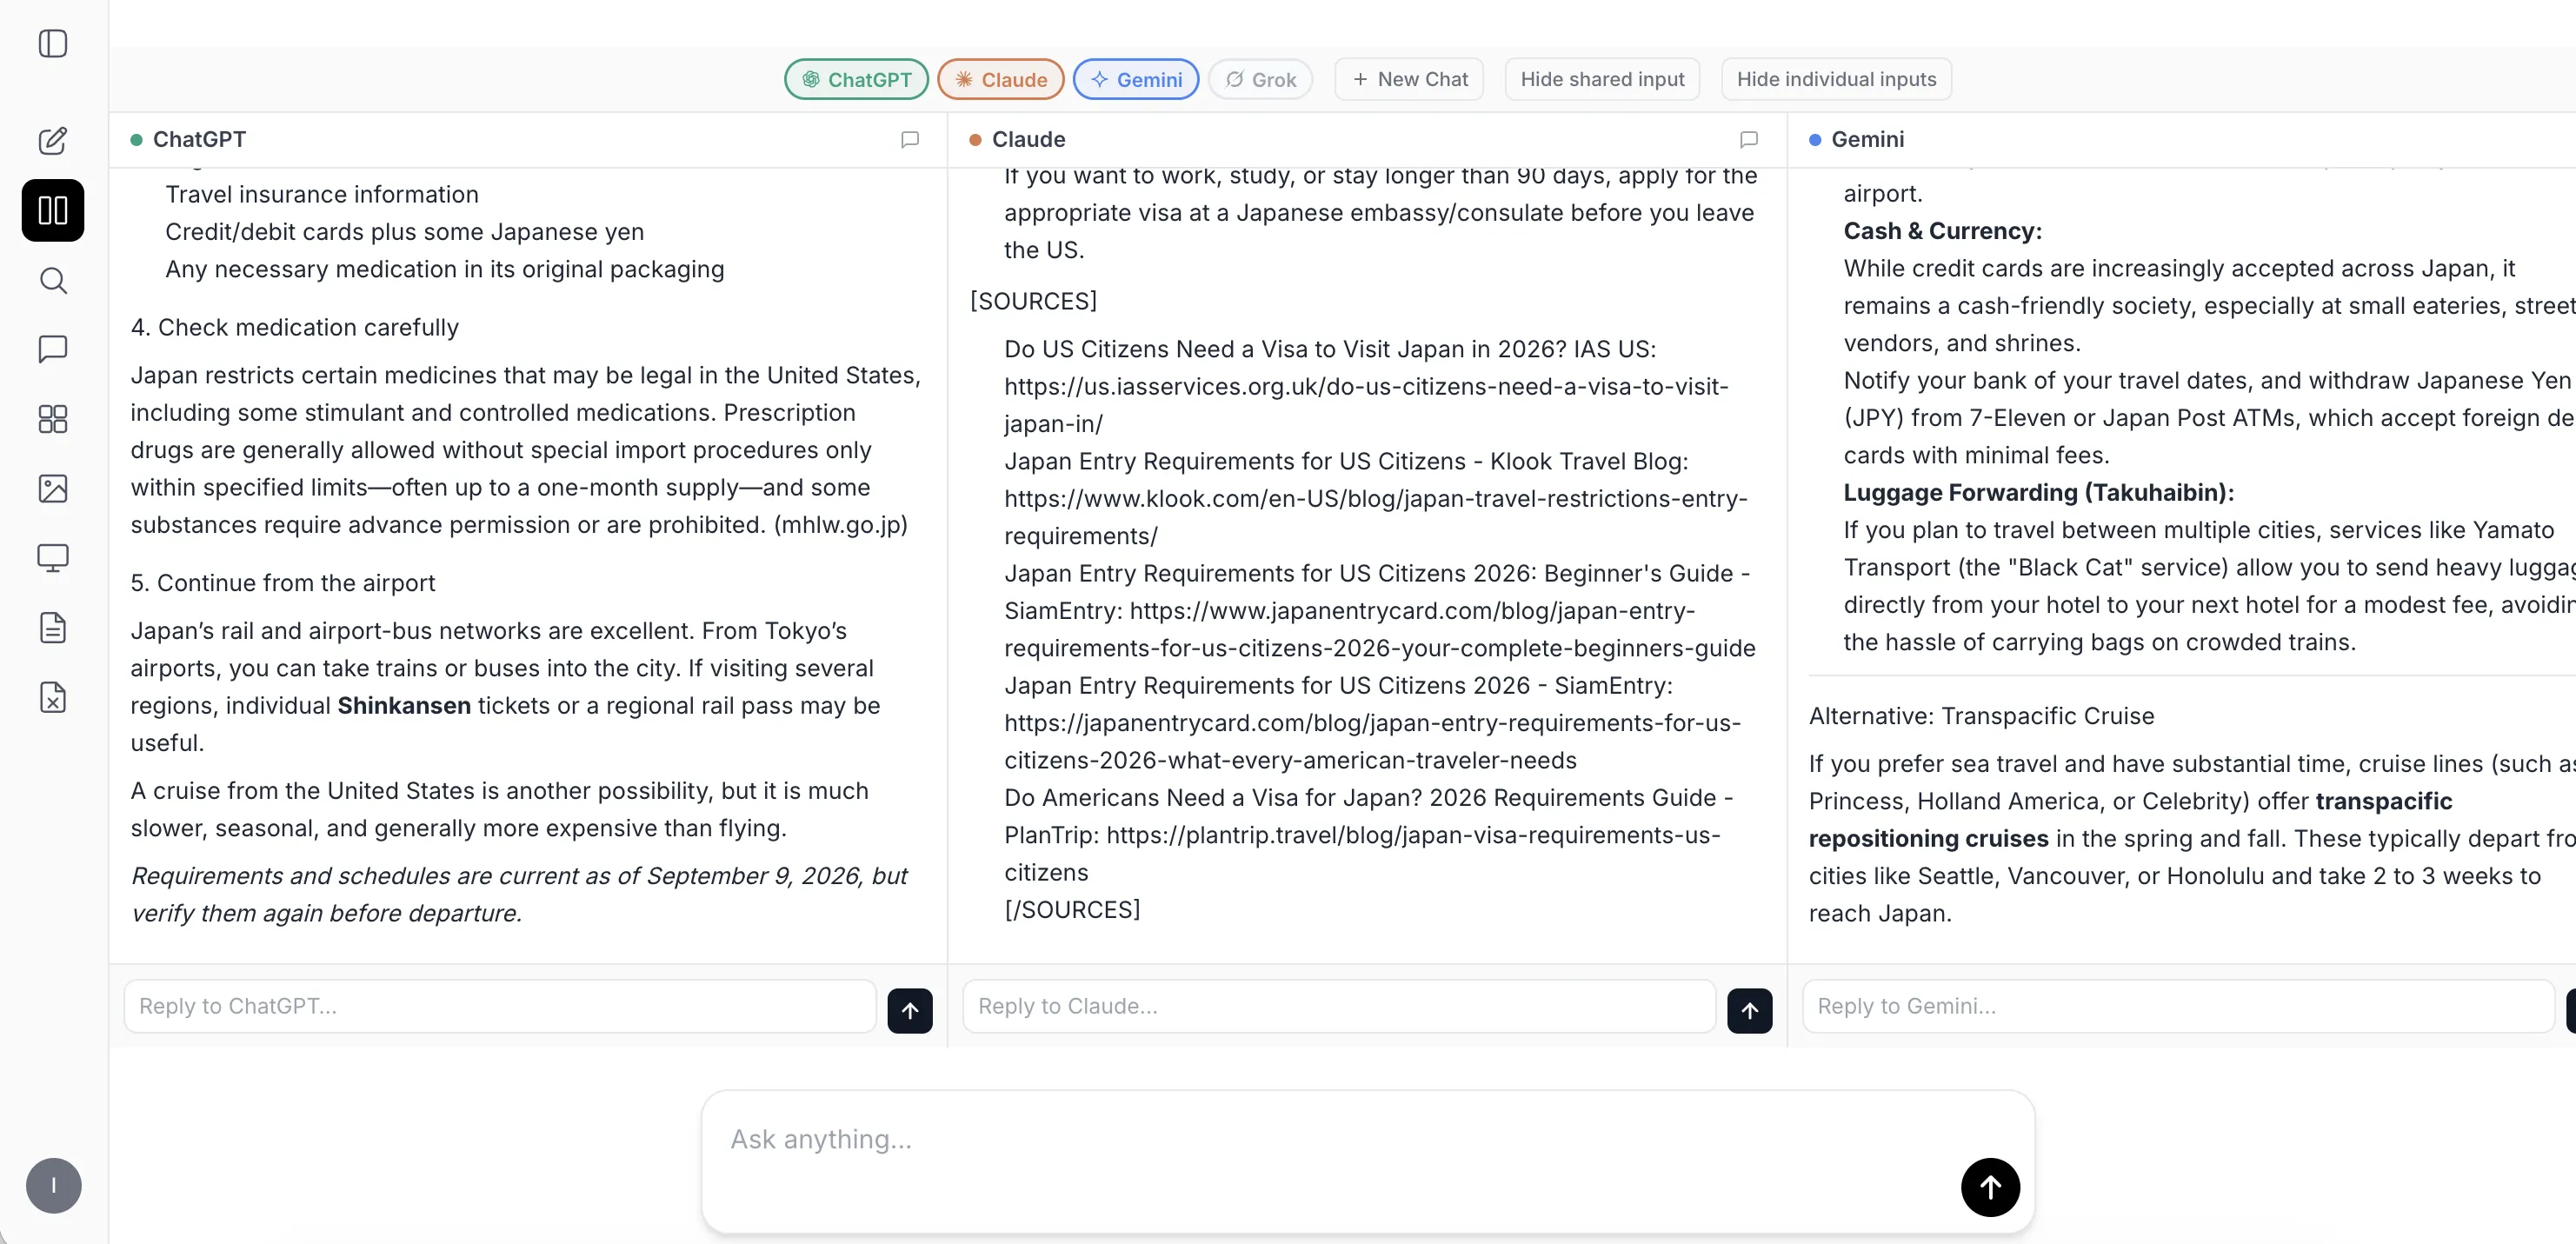
Bis zu 4 KI-Antworten nebeneinander – ohne eine vom Gedächtnis geprägte Beziehung.
Der Compare Mode sendet dieselbe Frage gleichzeitig an mehrere KI-Modelle und zeigt die Antworten nebeneinander. Er speichert Ihre Vorlieben nicht in einem Gedächtnisprofil, das künftige Antworten prägt.
Fazit
KI kann lügen. Behandeln Sie eine einzelne Antwort als Entwurf, nicht als Tatsache.
KI-Halluzinationen sind eine bekannte Eigenschaft heutiger Modelle, keine seltene Panne. Wenn es auf die Antwort ankommt, vergleichen Sie Modelle, öffnen Sie die Quellen und fragen Sie ohne Gedächtnis, bevor Sie handeln.
FAQ
Den sichereren Workflow testen
Lassen Sie nicht eine einzige KI für Sie die Realität definieren.
Nutzen Sie den Compare Mode von MultipleChat, um bis zu 4 Antworten verschiedener KI-Modelle nebeneinander zu erhalten, und erkennen Sie Halluzinationen dort, wo sie sich widersprechen.
Compare Mode aktivieren