
简短回答
是的,AI 可能会对你撒谎。
并非有意为之。AI 模型没有动机。但它可能编造一个事实、一句引语或一个法院案例,用自信的语气呈现出来,而且不给你任何出错的提示。对依赖这个答案的人来说,这就是谎言。
幻觉是主要原因。还有一小部分来自片面的表述、出于安全考虑而调整的回答以及个性化:带有记忆功能的助手可能会围绕它对你的了解来组织答案。无论哪种情况,解决办法都一样:不要让一个模型的一个答案成为最终结论。
造成真实后果的 AI 幻觉案例
这些都是有据可查的真实案例,而不是假设。在每个案例中,AI 的回答看起来都很专业,结果却是错的。
Mata v. Avianca:编造的法院案例
纽约一起人身伤害案中的律师提交了一份诉状,其中引用的案例是 ChatGPT 编造的。一名联邦法官对他们进行了处罚,并处以 $5,000 罚款。
启示:看起来正确的引用,并不能证明它真实存在。
Google Bard 的望远镜错误
在一段宣传演示中,Bard 声称詹姆斯·韦布空间望远镜拍下了太阳系外行星的第一张照片。实际上,那张照片是 2004 年由另一台望远镜拍摄的。当天 Alphabet 股价下跌 7.7%。
启示:即便是厂商自己精心挑选的展示答案,也可能出错。
Air Canada 聊天机器人的政策说明
这家航空公司的网站聊天机器人告诉一位痛失亲人的乘客,他可以在出行后申请丧亲折扣,但实际政策并非如此。仲裁庭驳回了 Air Canada 关于“聊天机器人应对自身言论负责”的辩称,并责令其赔付。
启示:要对照官方政策页面核查 AI 的回答。
AI 为什么会产生幻觉?
简而言之:语言模型非常擅长预测接下来应该出现什么文字,但它不是数据库。当它不知道某件事时,往往会给出听起来最合理的答案,而不是停下来。
它靠预测,而不是查询。除非模型连接了搜索或你的文件,否则它是根据训练中学到的规律来回答的,而规律可能出错。
罕见的事实没有规律可循。语法和常识会在数百万份文档中反复出现,但某个人的生日或一项冷门的法院判决可能不会,于是模型就会自行填补空白。
猜测会得到奖励。OpenAI 的研究人员在 2025 年指出,常见的训练和基准评分方式会给碰巧猜对的答案加分,而回答“我不知道”却得不到任何分数,这会促使模型倾向于给出自信的答案(OpenAI)。
训练数据会过时。在模型的训练截止日期之后,价格、法律、产品名称和人物都会发生变化。
你的提示词可能推波助澜。诱导性问题(“哪项研究证明了……?”)或索要模型并不掌握的来源,都会诱使它凭空编造。
幻觉并不是 AI 误导人的唯一方式
大多数错误答案都是幻觉。还有其他几种机制会产生在技术上站得住脚、却仍让你形成错误认识的答案。
测试记忆影响的提示词
“请先假设你对我毫无记忆来回答这个问题。然后再结合你对我的了解回答一次。准确指出两次回答有哪些不同。”
如何识破 AI 幻觉
只问一句“你确定吗?”是不够的。模型可能连续两次都自信地答错。要跳出对话本身来检验答案。
交叉核对相互独立的模型
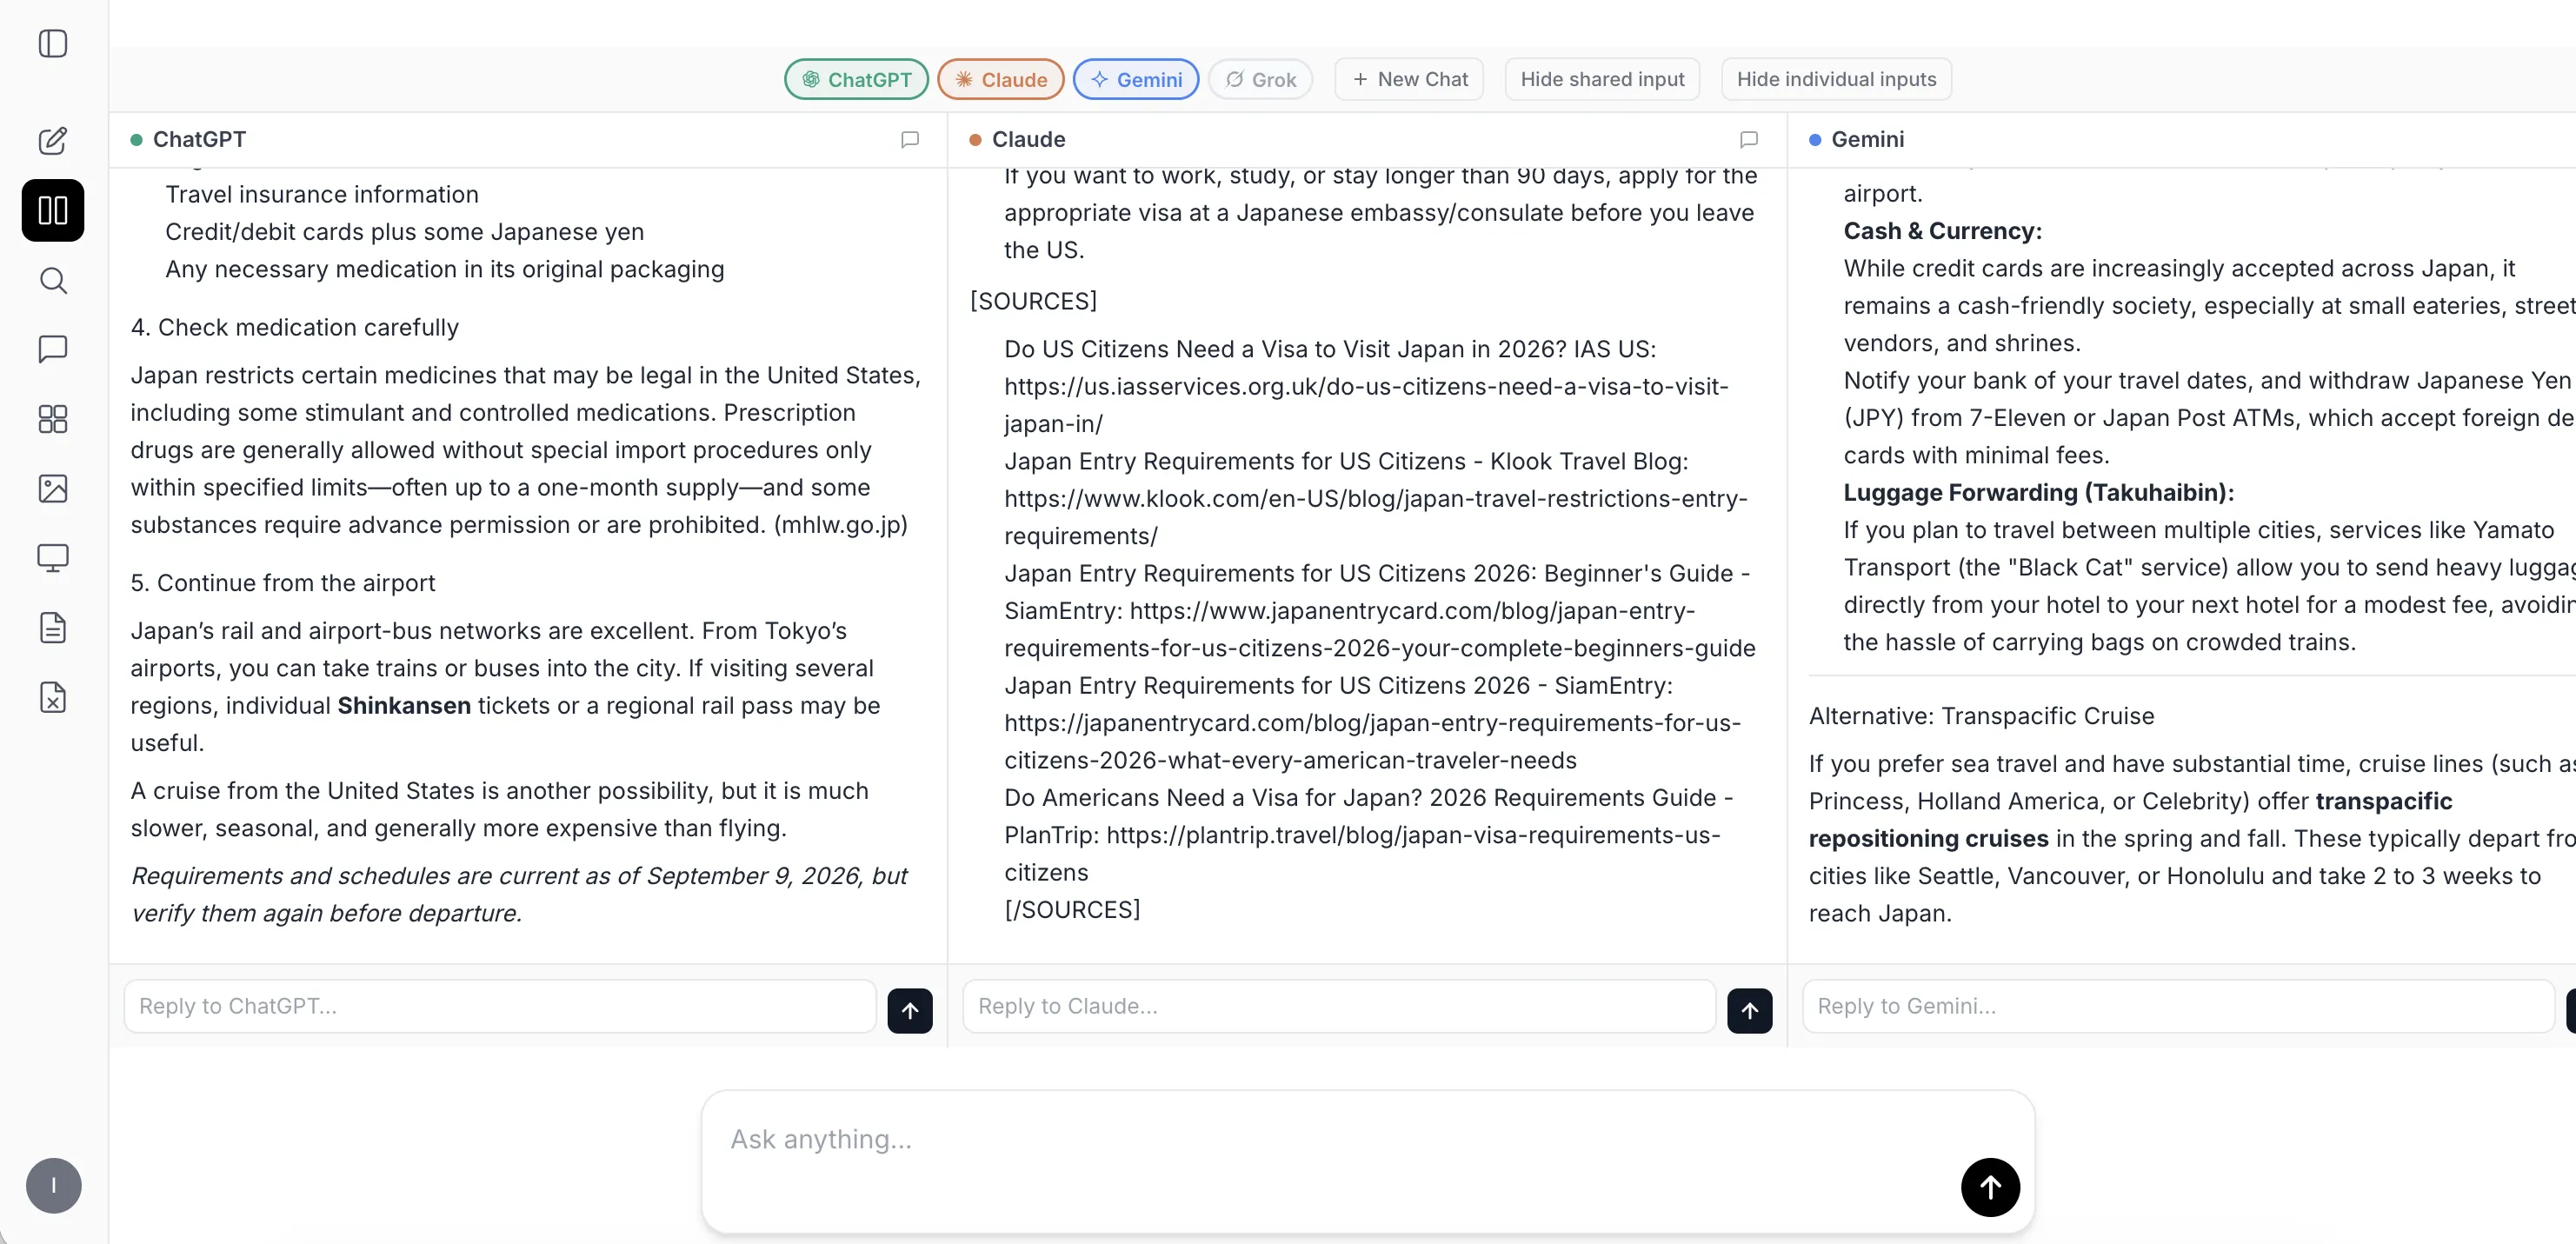
把同一个问题发送给多个模型。意见一致并不等于证据,但出现分歧时,就能准确看出该核查哪一条说法。MultipleChat 可以通过 Auto Verification 自动完成这一步。
打开每一个来源
点击链接、找到引语、阅读案例。如果找不到来源,就把这条说法视为未经核实。
在干净的上下文中再问一次
关闭记忆,在新对话中提问。如果答案发生了实质性变化,说明个性化在影响它。参阅如何在不使用记忆的情况下使用 AI。
高风险问题要升级处理
涉及法律、医疗、金钱、安全或就业时,把 AI 当作起点,并通过权威来源或合格的专业人士确认。
使用 MultipleChat Compare Mode
并排获取最多 4 个 AI 的回答,不受记忆塑造的关系影响。
Compare Mode 会把同一个问题同时发送给多个 AI 模型,并将答案并排显示。它不会把你的偏好保存到会影响未来回答的记忆档案中。
总结
AI 会撒谎。把一个答案当作草稿,而不是事实。
AI 幻觉是当今模型的已知特性,而不是罕见的故障。当答案很重要时,在采取行动之前,先比较多个模型、打开来源,并在不带记忆的情况下再问一次。
常见问题
试试更安全的工作流
别让一个 AI 替你定义现实。
使用 MultipleChat Compare Mode,并排获取最多 4 个不同 AI 模型的回答,并在它们出现分歧的地方发现幻觉。
启用 Compare Mode